OCR و پردازش هوشمند سند
OCR و پردازش هوشمند اسناد چیست؟ تفاوت OCR، IDP و RAG
OCR فقط تصویر را به متن تبدیل میکند؛ IDP باید نوع سند را بفهمد، فیلدها را استخراج کند، اعتبار بسنجد و نتیجه را وارد فرایند کند.
انتشار: · آخرین بهروزرسانی:
نویسنده: تحریریه پیکا با کمک هوش مصنوعی — پژوهش، نگارش و ویرایش فارسی
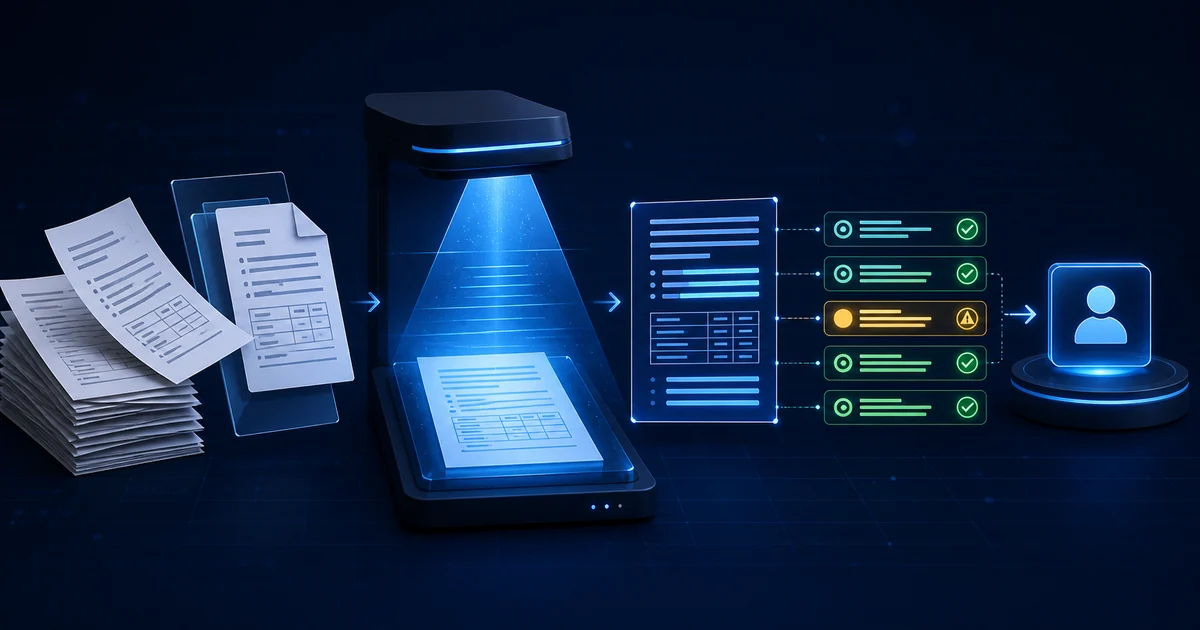
OCR فناوری تبدیل تصویر متن به متن قابل جستوجو و پردازش است. پردازش هوشمند اسناد یا IDP یک گام جلوتر میرود: سند را طبقهبندی میکند، فیلدهای مورد نیاز را بیرون میکشد، آنها را اعتبارسنجی میکند و نتیجه را به سامانه یا فرایند بعدی میفرستد.
تفاوت OCR، ICR، IDP و RAG
هر فناوری چه مسئلهای حل میکند؟
| فناوری | کار اصلی |
|---|---|
| OCR | تبدیل متن چاپی در تصویر به کاراکتر |
| ICR | شناخت دستنویس با دقت وابسته به نمونه |
| IDP | طبقهبندی، استخراج، اعتبارسنجی و تحویل داده سند |
| RAG | بازیابی بخش مرتبط سند برای پاسخ یا تولید متن مستند |
خط پردازش یک سند
- دریافت
فایل از اسکنر، ایمیل، بارگذاری، درگاه یا API وارد میشود.
- بهبود تصویر
چرخش، نویز، کنتراست و تفکیک صفحات اصلاح میشوند.
- OCR
متن و موقعیت آن روی صفحه استخراج میشوند.
- طبقهبندی
نوع سند مانند فاکتور، قرارداد یا نامه تشخیص داده میشود.
- استخراج
فیلدهای مورد نیاز و جدولها به ساختار مشخص تبدیل میشوند.
- اعتبارسنجی
قواعد، منبع مرجع و میزان اطمینان خطا را کنترل میکنند.
- بازبینی و ارسال
موارد نامطمئن به انسان و نتیجه معتبر به سامانه مقصد میرود.
کاربردهای سازمانی
- ثبت خودکار اطلاعات نامه وارده
- استخراج شماره، مبلغ و تاریخ فاکتور
- ساخت نمایه قرارداد و بندهای کلیدی
- خواندن فرمهای درخواست و پروندههای قدیمی
- ورود داده بارنامه، رسید و اسناد لجستیک
- قابل جستوجو کردن آرشیو PDF اسکنشده
- پوشاندن خودکار بخشی از دادههای حساس برای یک خروجی مشخص
دقت را چگونه اندازه بگیریم؟
یک عدد کلی برای دقت گمراهکننده است. دقت متن، دقت هر فیلد، نرخ سند بدون نیاز به بازبینی و هزینه اصلاح باید جدا سنجیده شوند. اشتباه در نام شرکت شاید قابل اصلاح باشد، اما اشتباه در مبلغ یا شماره حساب ریسک متفاوتی دارد.
- Character Error Rate برای کیفیت متن
- دقت و بازخوانی برای هر فیلد مهم
- نرخ پردازش مستقیم بدون دخالت انسان
- زمان متوسط بازبینی هر سند
- درصد سند ردشده یا نیازمند اسکن مجدد
- هزینه پردازش و اصلاح به ازای هر سند
فارسی، جدول و دستنویس چه چالشهایی دارند؟
اتصال و جداسازی حروف فارسی، اعداد فارسی و لاتین، مهر، جدول بدون کادر، اسکن کج و دستنویس کیفیت را تغییر میدهند. پایلوت باید با اسناد واقعی خود سازمان انجام شود؛ نمونههای تمیز فروشنده معیار کافی نیستند.
معماری انسان در حلقه
برای هر فیلد آستانه اطمینان تعیین میشود. موارد بالاتر از آستانه و مطابق قواعد میتوانند مستقیم عبور کنند؛ موارد مبهم در رابط بازبینی با برجستهسازی محل سند نمایش داده میشوند. اصلاح کاربر باید ثبت شود تا کیفیت و الگوهای خطا قابل تحلیل باشند.
امنیت و نگهداری فایل
فایل ورودی، متن استخراجشده و داده ساختاریافته هر سه میتوانند حساس باشند. محل پردازش، مدت نگهداری، رمزنگاری، مجوز مشاهده و ثبت رویداد باید برای هر سه لایه تعیین شود. متن OCR نباید خارج از سیاست دسترسی فایل اصلی قابل جستوجو باشد.
پرسشهای پرتکرار
OCR فارسی چقدر دقیق است؟
به کیفیت تصویر، فونت، ساختار صفحه و نوع محتوا وابسته است. تنها پاسخ معتبر، آزمون روی نمونه نماینده اسناد خودتان و گزارش خطا به تفکیک فیلد است.
آیا IDP جای ورود اطلاعات را کاملاً میگیرد؟
برای اسناد استاندارد و باکیفیت میتواند بخش بزرگی را خودکار کند؛ موارد مبهم و پرریسک همچنان به بازبینی نیاز دارند.
RAG جای OCR را میگیرد؟
خیر. اگر سند تصویر باشد ابتدا متن باید استخراج شود. RAG سپس بخش مرتبط همان متن را برای پاسخ یا جستوجوی معنایی بازیابی میکند.
طراحی مجموعه آزمون نماینده اسناد واقعی
برای پایلوت، نمونهها را بر اساس نوع سند، کیفیت اسکن، زبان، جدول، مهر و دستنویس طبقهبندی کنید. مدیریت اسناد الکترونیکی مشخص میکند کدام فیلدها برای جستوجو، نگهداری و دسترسی ضروریاند. مجموعه آزمون باید سهم هر گروه را شبیه ورودی واقعی نگه دارد؛ چند PDF تمیز فروشنده برای تصمیم تولید کافی نیست.
در هوش مصنوعی مکاتبات، خطای OCR مستقیماً روی موضوع، مقصد و خلاصه اثر میگذارد. کیفیت را به تفکیک مرحله گزارش کنید: نرخ خطای نویسه، دقت هر فیلد، طبقهبندی نوع سند و نرخ عبور بدون بازبینی. مبلغ و شماره حساب باید وزن ریسک بیشتری از یک واژه کماهمیت داشته باشند و آستانه اطمینان جدا بگیرند.
RAG جای OCR را نمیگیرد؛ متن استخراجشده را برای بازیابی استفاده میکند. در راهنمای RAG سازمانی، کیفیت بخشبندی و متادیتا به اندازه خود متن اهمیت دارد. مختصات صفحه و پیوند به فایل اصلی را نگه دارید تا کاربر بتواند هر پاسخ یا فیلد را با تصویر سند مقایسه کند و اصلاحات نیز برای تحلیل خطا ثبت شوند.
گزارش کیفیت مرحلهای
| مرحله | معیار اصلی |
|---|---|
| OCR | نرخ خطای نویسه و واژه |
| طبقهبندی | دقت و بازخوانی هر نوع سند |
| استخراج | دقت هر فیلد با وزن ریسک |
| عملیات | نرخ عبور مستقیم و زمان بازبینی |